Ang nakikita ng panel, at ang hindi
Isang 7-page PDF na naka-attach sa isang email. Iyon ang buong surface area na nakikita ng hiring panel. Hindi ang wizard, hindi ang mga timer, hindi ang auto-save o ang keyboard shortcuts o ang colour-coded scores. Nandiyan ang app para sa isang tao lang: ang interviewer, habang tumatakbo ang call.
Nasa PDF ang buong trabaho: mga score, mga note, mga strength at growth area, ang hire/reject decision, at apat na appendix ng ebidensya. Lahat ng kailangan ng panel para mag-offer o magpatuloy sa susunod.
Hindi haharapin ng karamihan sa mga hiring panel ang isang code-review tool, at kakaiba namang hilingin ‘yon sa kanila. Ang trabaho nila ay ang desisyon, hindi ang data entry. Ang trabaho ng app ay tiyakin na ang data sa pahina ay karapat-dapat sa atensyon nila.
Bago makarating doon, dumaan ako sa dalawang format, binitawan ko ang isang ideya bago pa magsimula, at may isang bug na muntik nang magpadala ng maling score kung hindi sana ito nahuli ng isang test run.
Ang problema sa format
Dinisenyo ko ang mga scorecard para sa React Native hiring process namin noong unang bahagi ng taong ito. Tatlong assessment: isang 100-check code review, isang walkthrough interview na may score na 1 hanggang 5, at isang behavioural interview na naka-map sa limang values namin. Gumagana ang scoring. Hindi gumagana ang format na ginagamit ko para makuha ang mga score na iyon habang tumatakbo ang live call.
Ang walkthrough interview ang pinakamahirap na bahagi. Isang kandidato ang nagsa-share ng screen niya, dinadala ka niya sa tech test na ginawa niya, at ipinapaliwanag ang mga desisyon niya. Kailangan kong magbasa ng isang scripted question, makinig, i-score nang 1 hanggang 5, magsulat ng mga note, tingnan ang oras, at lumipat sa susunod. Lahat ito habang pinapanatili ang eye contact at natural ang usapan.
Subukan mong gawin iyon sa isang markdown table sa loob ng VS Code. Mapupunta ang cursor sa maling cell. Magta-drift ang scroll position. Naririnig ng kandidato ang pag-type mo at babagal siya.
Notion, markdown, tapos isang React app
Notion ang naisip ko muna. Ginagamit ko ito sa lahat ng personal kong gawain. Hindi naman ito tool na ginagamit namin sa trabaho, at ang pagbuo sa isang platform na ako lang ang gagamit ay parang dead end. Binitawan ko ang ideya bago pa man magsimula.
Markdown files ang sumunod. Isang .md para sa bawat scorecard, mga table para sa mga score, espasyo para sa mga note. Maganda ang takbo nito para sa code review. 100 yes/no checks na tinatapos mo pagkatapos ng interview sa sarili mong oras. Ang walkthrough at behavioural scorecards ay kailangang gumana habang tumatakbo ang call, at humaharang ang markdown. Hanapin ang tamang row, mag-type ng numero, mag-scroll sa susunod na section. Tama, pero mabagal. Mas maraming atensyon ang napupunta sa dokumento kaysa sa tao.
Mas masama ang sumunod sa interview. Tatlong magkakahiwalay na markdown files sa tatlong iba’t ibang format, na manu-manong pinagsama sa isang coherent document para sa recruitment team. Bawat beses, mas matagal ito kaysa sa gusto ko.
Sa huli, sa isang localhost React app ako humantong. Walang backend, walang database, walang deployment. npm run dev lang at isang browser tab. Lahat ay nase-save sa localStorage. Namamatay ang app kapag isinara ko ang tab at bumabalik kapag binuksan ko muli.
Buong atensyon sa call
Ang buong layunin ay tumigil sa pakikipaglaban sa tool habang tumatakbo ang interview. Tatlong bagay ang gumawa ng pagkakaiba.
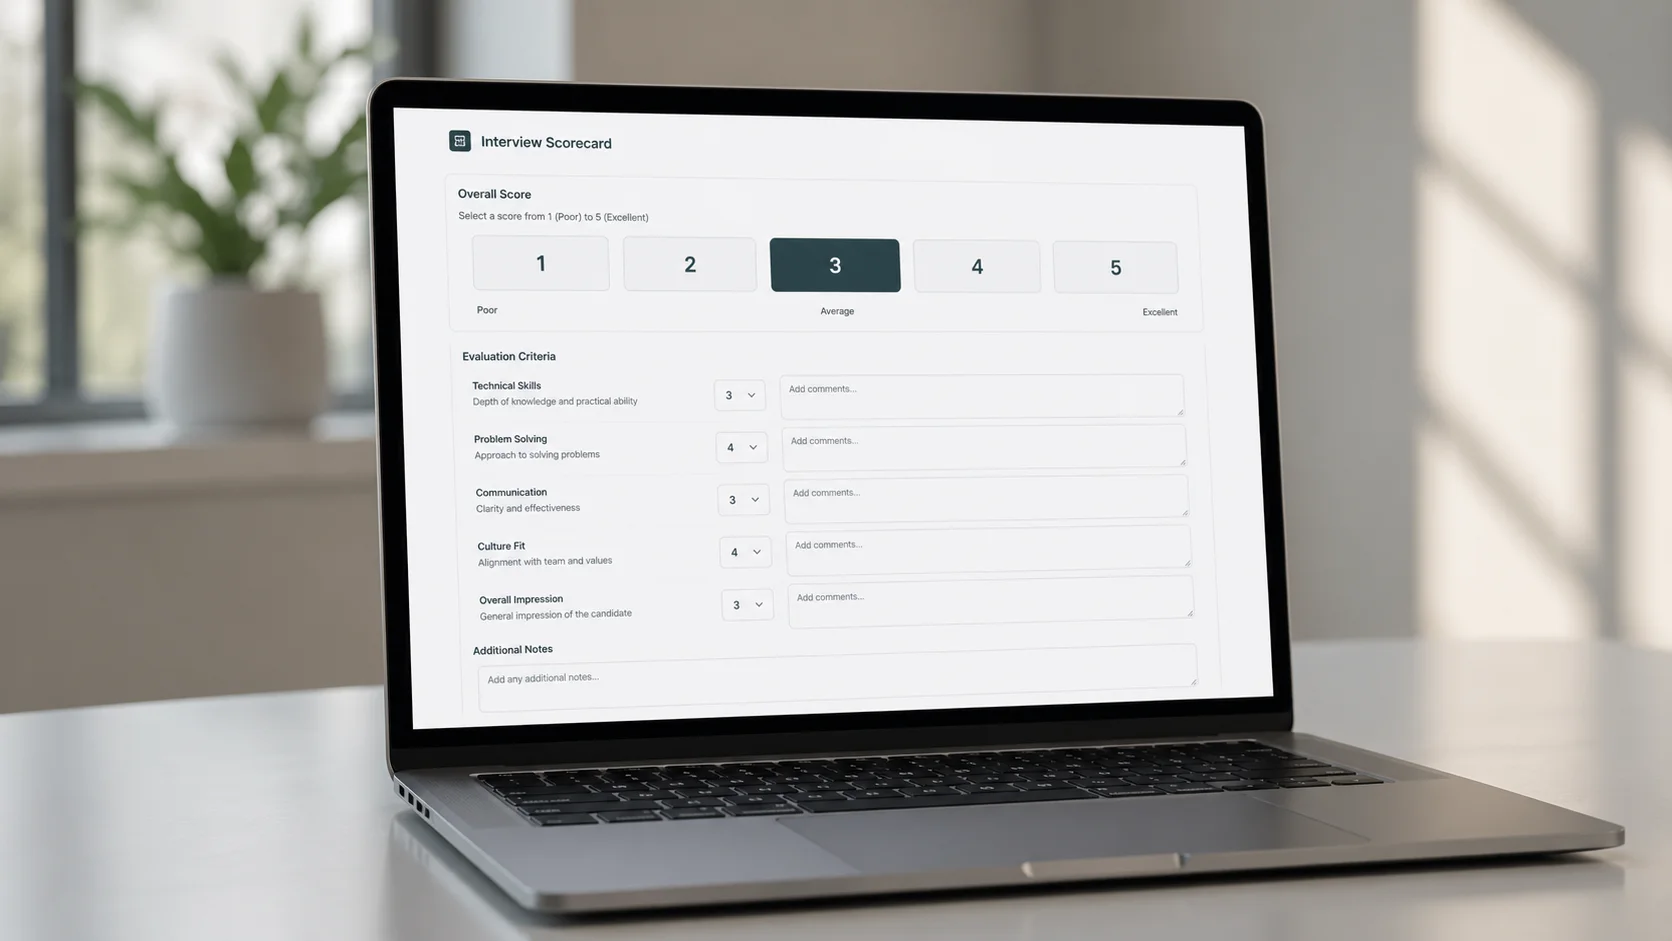
Isang tanong bawat screen. Ang walkthrough ay isang wizard. Ang bawat hakbang ay nagpapakita ng script na babasahin nang malakas (sa isang blue blockquote para mahanap ko ito agad), ang mga tanong na may malalaking 1 hanggang 5 buttons, at isang notes field. Walang scroll. Walang paghahanap ng tamang section. Pindutin ang “Next” at lumalabas ang susunod na grupo. Para sa senior candidates, ang wizard ay umaabot mula 4 na hakbang hanggang 8 na may dagdag na Part B sa system design.
Keyboard scoring. Pindutin ang 1 hanggang 5 at agad na nare-record ang score. Walang clicks, walang dropdown menus, walang confirmation dialogs. Nananatili ang mga mata ko sa video call. Nasa gilid lang ng paningin ko ang scoring.
Isang section timer sa sulok. Hindi countdown, tahimik na elapsed-time display lang. Sinilip ko ito sa unang walkthrough at napansin kong gumugol ako ng 8 minuto sa isang section na dapat ay 4 lang. Kung wala ito, lampas na sana ako sa oras at napilitan sana akong putulin ang huling section. Mawawalan sana ng tsansa ang kandidato na sagutin ang mga tanong na maaaring nagpataas sa score niya.
Ang bug na nag-score nang pareho sa lahat
Ang stack noon ay React 19, TypeScript, Vite, Tailwind v4. Walang state management library ang unang bersyon: isang custom useLocalStorage hook at React Router.
Habang nagte-test, in-score ko ang walkthrough ng isang kandidato mula umpisa hanggang dulo. Bawat section, bawat tanong, kumpletong notes. Pinindot ko ang “Next” para makarating sa summary screen at nakita kong pare-pareho ang score ng lahat ng section: kung ano ang inilagay ko sa huling hakbang.
Isang stale closure bug. Kina-capture ng useCallback ng bawat wizard step ang walkthrough data mula sa nakaraang render. Nang mag-save ang step 3, na-overwrite nito ang steps 1 at 2 dahil hawak pa rin nito ang lumang state.
Ang fix: huwag nang pagkatiwalaan ang view ng React sa data tuwing nagse-save. Sa bawat mutation, direktang binabasa ang kasalukuyang candidate state mula sa localStorage imbes na sa closure na na-capture na. Isang freshCandidate() helper na tumatawag sa localStorage.getItem sa bawat save. Hindi elegante. Gumagana sa bawat pagkakataon.
function freshCandidate(id: string): Candidate | undefined {
  const raw = localStorage.getItem('ik-candidates');
  if (!raw) return undefined;
  return JSON.parse(raw).find((c: Candidate) => c.id === id);
}
Umuulit ang parehong pattern sa tatlong hooks: useWalkthrough, useBehavioural, useCodeReview. Bawat isa, laging sariwa ang data na binabasa nito sa bawat read at sariwa rin ang sinusulat sa bawat save, at nagpapadala ito ng custom event (ls-sync) para makuha ng ibang hook instances ang pagbabago. Dalawampung linya ng persistence code. Walang Redux, walang context providers, walang middleware. Ang dalawampung linyang ‘yon ang nagpatakbo sa mga unang totoong interview; kalaunan, ginawang pormal ang store sa Redux Toolkit habang lumalaki ang app.
Ang PDF na walang nakakakita habang ginagawa ko
Pagkatapos ng interview, pinipindot ko ang “Print / PDF” at ang browser ay bumubuo ng isang Candidate Assessment Report. Walang PDF library. Print CSS lang.
Ang Page 1 ay ang summary: isang score table, ang recommended level band, ang hire/reject decision, at ang offer level. Ang Pages 2 at 3 ay nagpapakita ng strengths at growth areas mula sa lahat ng tatlong assessment, na naka-group ayon sa pinanggalingan. Tapos apat na appendix: code review breakdown, walkthrough scores na may bawat tanong at note, behavioural scores ayon sa value, at isang level bands reference table na may band ng kandidato na naka-highlight sa navy.
Ang level bands table na iyon ay nagma-map ng combined score sa isa sa 12 tiers: mula Graduate 1 hanggang Senior 2+. (Ang apat na bands mula sa post tungkol sa scorecard ay hinati sa tig-tatlong tiers nang magsimulang mapunta sa pagitan ng mga ito ang mga totoong kandidato.) Ang 2+ tier ay sadyang mahirap abutin. Tumutukoy ito sa isang taong nasa pinakatuktok ng kategorya niya, papunta sa susunod. Kapag nakita ng isang panel member ang “Associate 2+” sa PDF, agad ang pagkakabasa: malakas na Associate, hindi pa SE. Mas marami ang sinasabi ng isang label na ‘yon kaysa sa isang talata ng paliwanag.
Ang behavioural gate ay nagdadagdag ng pangalawang check. Ang isang kandidato na may score na mas mababa sa 10/25 sa values ay hindi nagpapatuloy, kahit anuman ang technical score niya. Ang 10 hanggang 14 ay nagti-trigger ng panel discussion. Ang 15 pataas ay pumapasa sa gate. Maaaring ituro ang technical skills. Ang mga values mismatch ay nagpapalaki ng problema sa paglipas ng panahon.
Ibang disiplina ang print CSS
Mas maraming CSS ang sinulat ko para sa @media print kaysa sa screen. Ito ang bahaging pinaka-ikinagulat ko.
Ang navy background ng combined score box? Hindi ito napi-print. Ang mga browser ay nag-aalis ng background colours by default (ino-override iyon ng print-color-adjust: exact sa bawat element, pero iba-iba ang mga engine at kailangan pa ng lumang WebKit ng -webkit- prefix). Kaya kino-convert ko na lang ito sa isang puting kahon na may makapal na itim na border gamit ang [style*="background: #002147"] selectors sa print stylesheet, para hindi kailanman nakadepende sa isang print setting kung mababasa nang maayos ang report. Ang Tailwind utility classes tulad ng bg-white ay tina-target gamit ang attribute selectors ([class*="bg-white"]) para i-override ang padding, borders, at margins para sa print.
Ang page-break-inside: avoid ay isang suggestion, hindi command. Magpe-page break ang browser sa loob ng isang element kung ang alternative ay isang halos walang lamang pahina. Gumugol ako ng isang oras sa pag-debug kung bakit ang isang strengths section ay nahahati sa dalawang pahina bago ko napansin na ang content ay sobrang taas para sa natitirang espasyo.
Ang heading styles ay nangangailangan ng explicit inline border-bottom dahil ino-override ng print reset ang mga deklarasyon ng Tailwind utilities. Ang font sizes ay nagbabago mula rem patungo sa pt. Ang interactive elements (textareas, checkboxes, dropdowns) ay nakatago. Ang buong print layout ay nasa isang separate na CandidatePrintReport component na nagre-render sa loob ng hidden print:block. Malinis na separation. Hindi nakikita ng screen ang print layout, hindi nakikita ng print ang mga buttons.
Kung gagawin ko ulit ito, ide-design ko muna ang print layout at pangalawa ang screen layout. Ang PDF ang artefact na mahalaga. Ang screen ay input form lang.
Kung ano ang babaguhin ko
Tests bago ang scoring logic. Ang red flag deductions, stretch bonuses, level band lookups, ang behavioural gate threshold. Pure functions na ang mga ito ngayon, na-extract sa utils/scoring.ts, at sila ang uri ng code na nasisira nang tahimik kapag nag-tweak ka ng isang boundary. Sinulat ko sila sa huli. Dapat sila ang nauna.
Ang markdown import parser ay marupok. Gumagamit ito ng regex para basahin ang Y/N values mula sa mga scored code review files. Gumagana ito para sa specific format na dinisenyo ko, pero ibang table layout o isang dagdag na column at masisira na. Ang isang totoong parser na may error recovery ay mas matibay.
Ang accessibility ay naidagdag nang huli. Ang WCAG AA na trabaho (per-route page titles, heading hierarchy, colour-contrast ratios, roving tabindex sa score selectors, aria-live sa save indicators) ay na-retrofit sa halip na binuo mula sa simula. Mas malinis sana kung ginawa ko itong accessible mula sa simula. Karapat-dapat sa internal tools ang parehong standards ng public-facing tools.
Ang totoong test
Ginamit ko ang app na ito sa unang pagkakataon sa isang totoong interview noong nakaraang linggo. Hindi alam ng kandidato na may ginagamit akong kakaiba. Ipinakita niya ang take-home submission niya, nag-score ako, nag-usap kami. Walang scrolling, walang pag-type sa markdown tables, hindi ako naliligaw sa dokumento. Pagkatapos ng call, isang pindot ng button at handa na ang PDF.
Iyon ang buong punto. Ang scoring, ang timers, ang level calculations, at ang PDF generation ay hindi nakaharang: binabasa ng panel ang PDF, nag-uusap ang kandidato, at tahimik ang tool sa pagitan ng dalawa.