El post 9 va acabar amb una promesa: l’stack es queda igual i el backend es parteix en dos, REST per a la llista, GraphQL per a les insígnies de tipus, un client i un cache. Aquest post ho construeix.
El signe d’interrogació del títol és deliberat. Durant la transició, amb un backend GraphQL acabat d’arribar i REST encara en marxa, guanya tenir un sol client, i gairebé no importa quin, i si la teva app ja fa servir RTK Query, això ho decideix. A la destinació, amb GraphQL a tot arreu, la resposta depèn de dues coses que pots comprovar contra la teva app: si tens una restricció de federació, i si el teu esquema és prou relacional perquè un cache normalitzat s’hi guanyi el lloc. Un cache normalitzat desa cada entitat una sola vegada, un Pokémon en una única entrada, de manera que cada vista que hi apunta llegeix la mateixa còpia. Aquesta sèrie té federació, així que aquí RTK Query continua sent la tria. Canvia el context i canvia la resposta, i aquest post diu on.
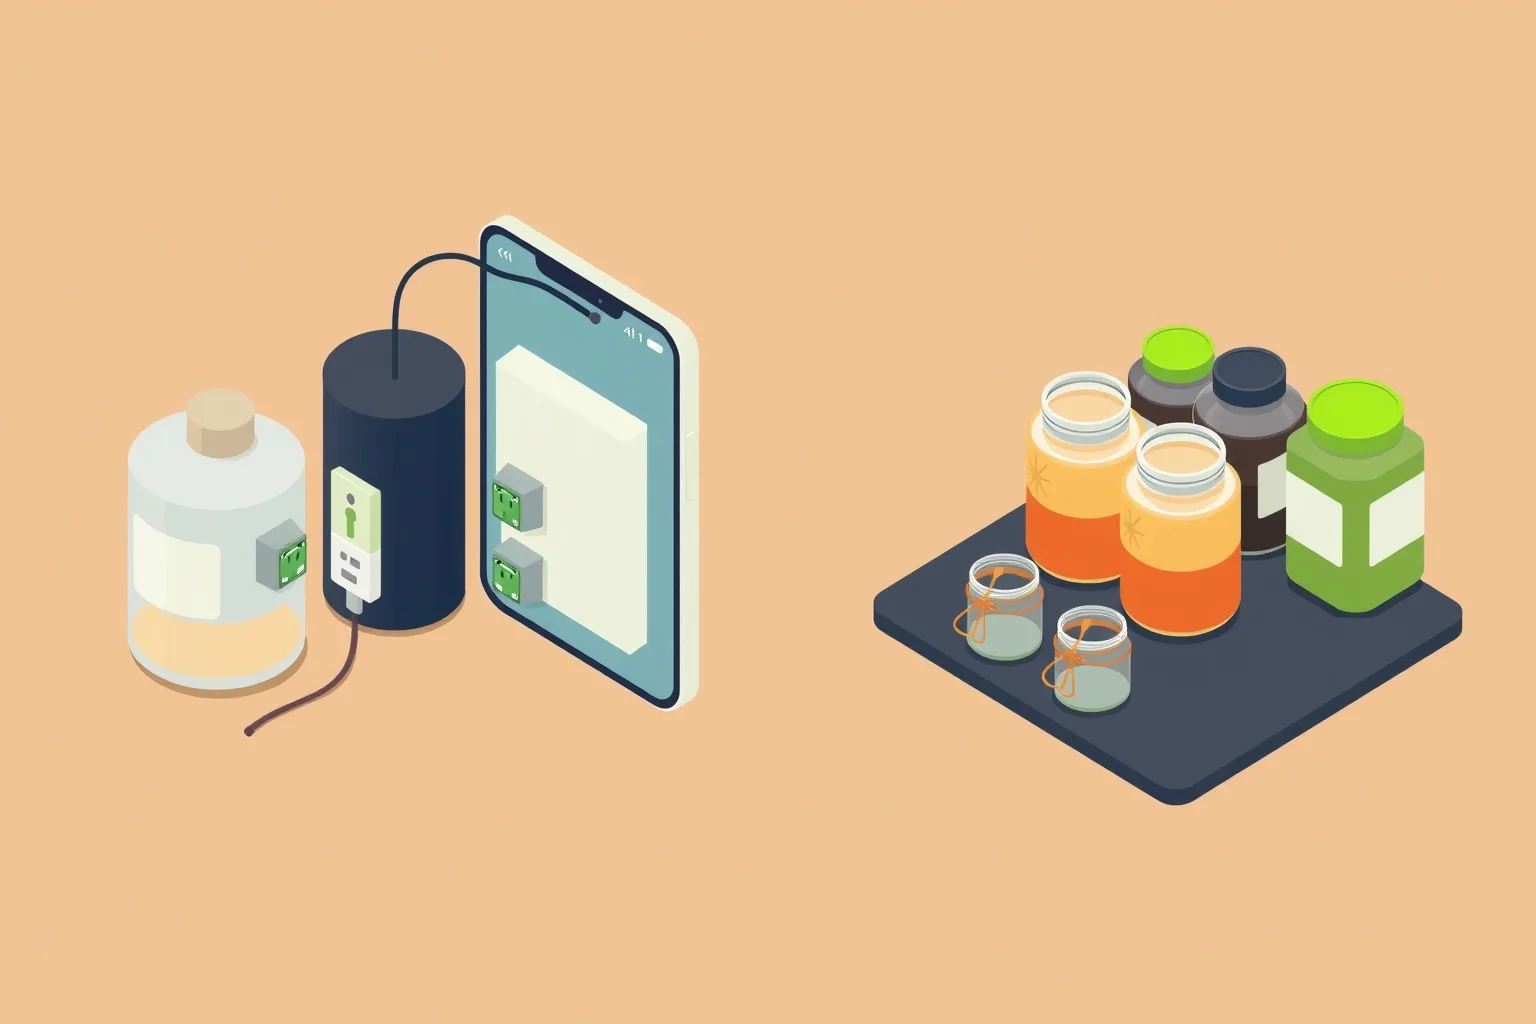
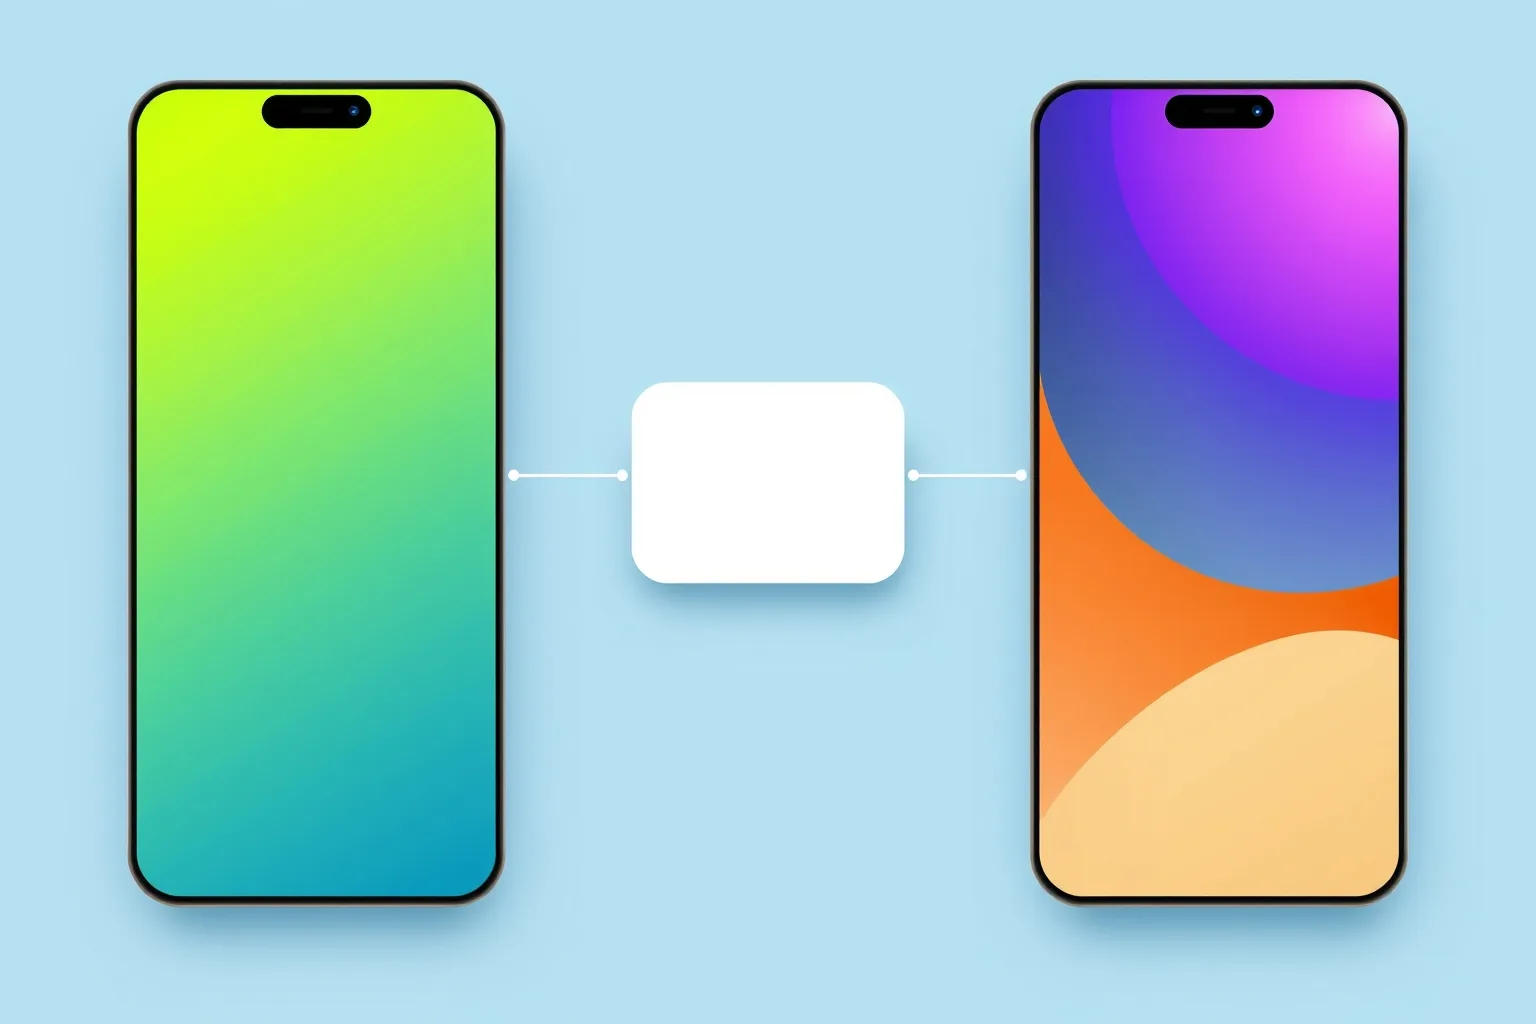
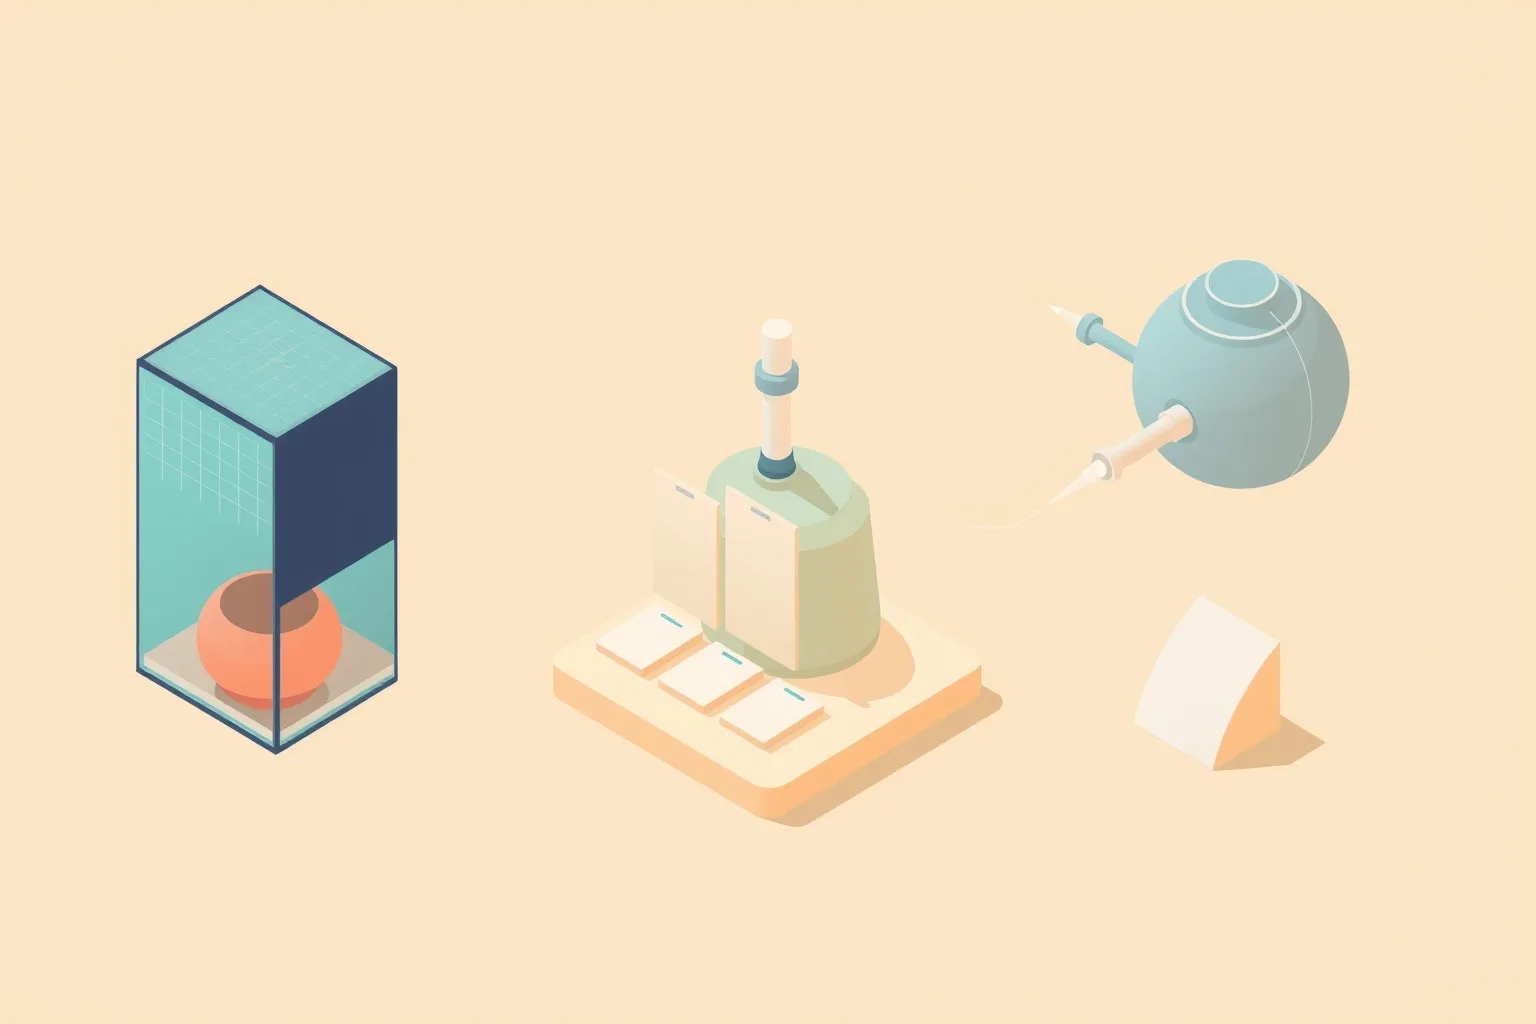
La forma de l’esquerra és la construcció: REST i GraphQL alimenten un sol cache de baseApi sota un únic graf de tags, amb el botó de Refresh del host intacte. La de la dreta són dos clients amb dos caches i cap aresta entre ells. Aquesta aresta que falta és el tema real d’aquest post.
Arriba un segon backend
L’equip d’API munta GraphQL. Per a les pantalles que necessiten dades relacionades pot substituir diversos viatges d’anada i tornada per un de sol, que és d’on surt la millora i no del protocol mateix, i és cap on va el backend. REST no desapareixerà aquest trimestre, ni el que ve. Durant un temps, sovint llarg, tots dos conviuen, i cada pantalla la serveix l’un o l’altre.
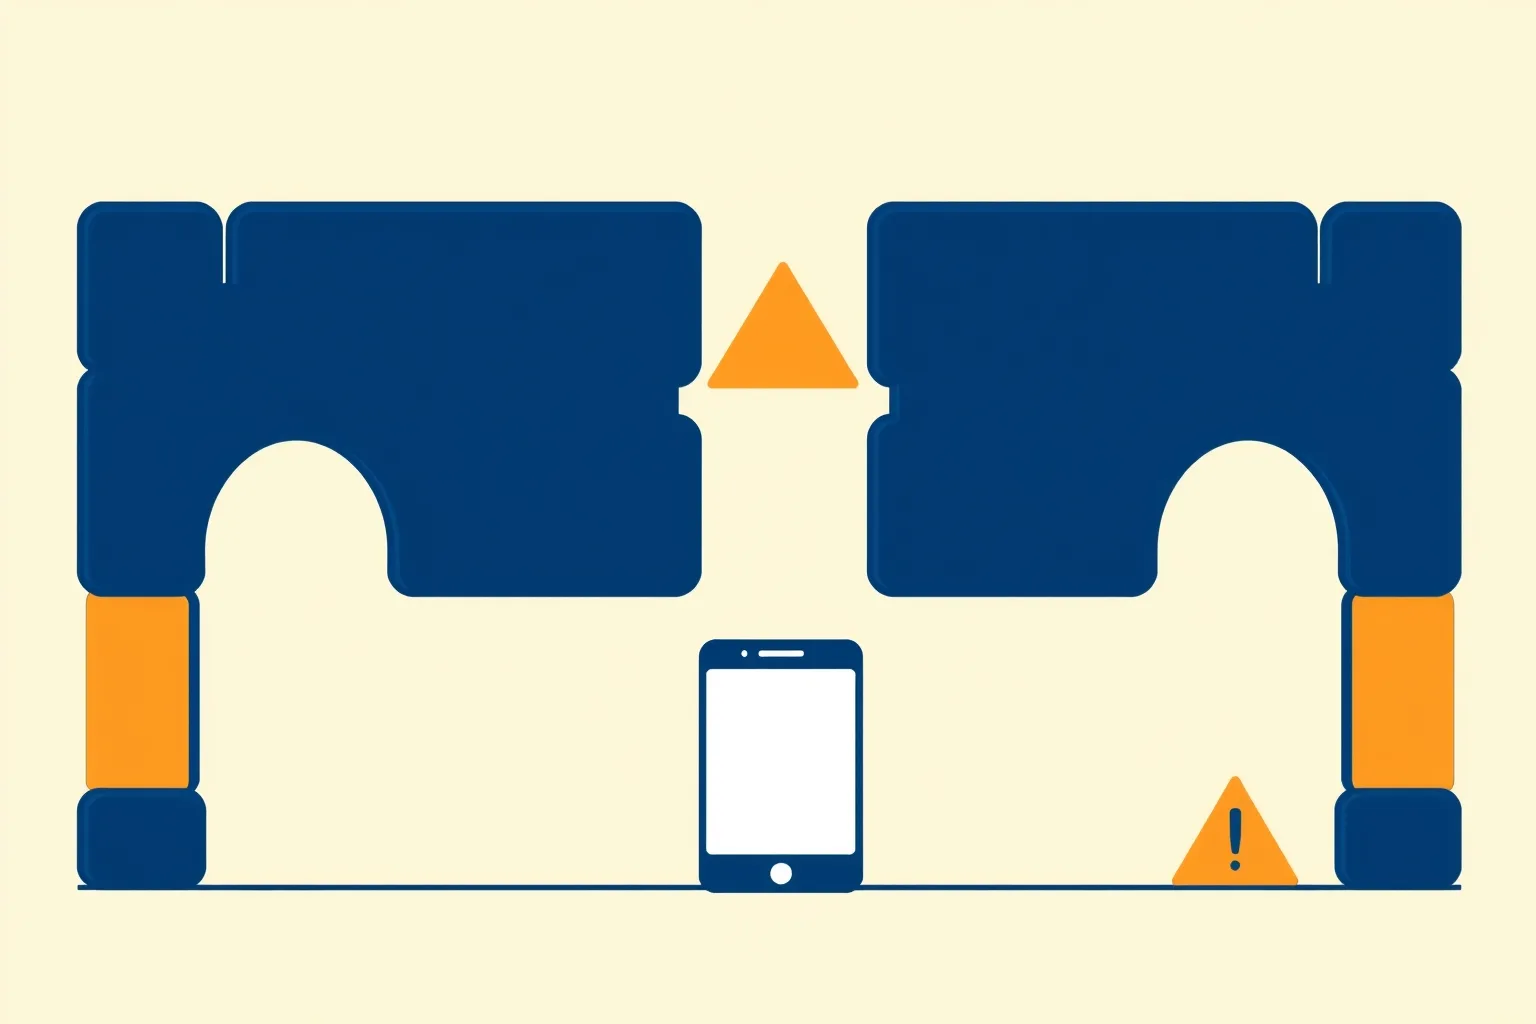
El perill és executar dos clients de dades alhora, siguin quins siguin. Dos clients mantenen dos caches, i els dos caches no es parlen. Una mutació que surt per GraphQL actualitza el cache de GraphQL, i l’actualització no arriba mai al cache REST que desa el mateix registre. L’usuari edita un Pokémon a la pantalla servida per GraphQL, canvia a la llista servida per REST, i veu el valor antic. No salta cap excepció, no falla cap petició, no hi ha cap avís. Només una pantalla que queda equivocada, en silenci, fins que alguna cosa força un refetch. A mig camí de la transició, quan els dos backends se solapen més, és exactament quan fa més mal.
Així que la pregunta de la transició és quants caches calen, i la resposta més barata és un.
Un slice, dos protocols
RTK Query fa que un sol cache serveixi els dos protocols, a l’slice que aquesta sèrie executa des del post 6. Comença des del tag del post 8:
git clone https://github.com/warrendeleon/react-native-module-federation
cd react-native-module-federation
git checkout post-08-client-state
La llista ja demana les seves files per REST. Ara li sorgeix una segona necessitat d’estat de servidor, una insígnia de tipus a cada fila, servida per GraphQL. Primer, dues dependències, només al remote list. graphql es queda a la 16 perquè graphql-request declara un rang de peers de 14 a 16 mentre que l’última a npm és la 17:
( cd apps/list && npm install graphql@16.14.2 graphql-request@7.4.0 )Després l’endpoint, al mateix slice d’api:
const typesApi = baseApi.injectEndpoints({
  endpoints: build => ({
    getPokemonTypes: build.query<Record<number, string[]>, void>({
      async queryFn() {
        try {
          const raw = await request(GRAPHQL_URL, POKEMON_TYPES);
          return { data: parsePokemonTypes(raw) };
        } catch (err) {
          return {
            error: {
              status: 'CUSTOM_ERROR',
              error: err instanceof Error ? err.message : 'Invalid GraphQL response',
            },
          };
        }
      },
      providesTags: ['PokemonList'],
    }),
  }),
});

export const { useGetPokemonTypesQuery } = typesApi;
Un slice d’api té exactament un baseQuery, i el de la llista és fetchBaseQuery sobre la base REST. Un segon protocol contra una altra URL surt d’un queryFn, que la documentació oficial de RTK recomana per a «one-off queries that use a different base URL». graphql-request envia la query, i aquest mateix fitxer porta el que l’extracte deixa fora: la query de GraphQL limitada i ordenada, l’esquema de Zod que vigila els ids i els noms de tipus, parsePokemonTypes i la integració amb la pantalla. En comptes d’imprimir-ho tot, deixa el teu arbre a l’estat final:
npx degit@3.8.0 --force warrendeleon/react-native-module-federation#post-10-two-backends /tmp/pokedex-ref-10
cp -R /tmp/pokedex-ref-10/. .
La resposta es valida amb el seu propi esquema de Zod a la frontera que la llista REST ja protegeix, que es manté igual perquè la comparació canviï només el protocol. L’esquema viu a l’app list i no al paquet de contractes, perquè una definició de dades viatja amb el domini que n’és el propietari (la regla del post 7).
El GraphQL de PokéAPI viu a
graphql.pokeapi.co/v1beta2. L'esquema anticv1betaestà retirat, i amb ell el prefix de campspokemon_v2_que omple tots els tutorials anteriors al 2025. Demanarpokemon_v2_pokemonavui retornafield 'pokemon_v2_pokemon' not found in type: 'query_root'. La forma que funciona és la que va sense prefix, comprovada en viu contra l'endpoint en escriure aquest post.
Dues coses falten a propòsit. No hi ha nova versió de contracts: l’endpoint s’injecta al baseApi existent i declara el tag que ja és de la llista. I graphql-request es queda fora de les entrades shared de Module Federation, exactament igual que Zod. Només exporta valors, no té una identitat d’instància per compartir, així que viatja com a dependència pròpia del remote list. Quin protocol va servir cada fila és assumpte privat del remote, invisible per al host i per a tots els altres remotes.
El GraphQL de PokéAPI té un límit de 100 crides per hora i per IP, mentre que REST només demana un ús raonable. El cache de RTK Query l'absorbeix amb un ús normal. Una tanda de recàrregues en fred encara pot esgotar-lo, i un 429 mentre construeixes és el límit, no un bug.
Un tag per a tota la transició
El botó de Refresh del host despatxa invalidateTags(['PokemonList']) des del post 6, i no guarda cap referència a cap dels dos endpoints. Tant la llista REST com la query de tipus per GraphQL proveeixen 'PokemonList', així que una sola premuda torna a demanar totes dues. El panell Network de les DevTools de React Native ho mostra en directe: un toc llança les dues peticions juntes, i la vista prèvia de v1beta2 ensenya les dades de tipus arribant per GraphQL.
Aquesta és la tesi de la transició en un sol tag: triïs el client que triïs, queda’t només amb un. Res no creua de manera automàtica, això sí. Una mutació neteja el cache de l’altre protocol quan anomena el tag que tots dos proveeixen, i només llavors; el graf compartit és el que ho fa possible, no el que ho executa.
La mateixa carrera es veu al dispositiu: en una arrencada en fred les files REST aterren primer, i les insígnies de GraphQL arriben un moment després, a mesura que cada query va omplint el cache compartit:
Les insígnies també es degraden en silenci. Apunta l’endpoint GraphQL a un host inaccessible i les files es renderitzen igual, les insígnies simplement no hi són, i res no es mou a la pantalla.
Les insígnies també posen números a la promesa de GraphQL mateix. Els tipus per REST serien 151 crides de detall, una per fila, perquè l’endpoint de llista només retorna noms i URLs. Per GraphQL és una única query. Digues-li pel seu nom, fan-out de peticions des del client i no N+1: el problema clàssic descriu un backend que repeteix un accés a dades per fila, mentre que aquí és un client el que fa una petició per fila perquè l’endpoint no li dona res més. El guany són menys viatges d’anada i tornada, i és un punt per al protocol, no per a cap dels dos clients.
El que Apollo fa i això no
RTK Query tracta una resposta GraphQL com a dades per desar al cache per endpoint, igual que qualsevol payload REST. Apollo fa una cosa que RTK Query ni intenta: amb el seu InMemoryCache per defecte, normalitza. Cada objecte amb un __typename i un id rep una única entrada al cache, i cada query que hi fa referència llegeix aquesta entrada. Una mutació que retorna el mateix tipus i el mateix id actualitza l’entitat a tot arreu on apareix, sense cap refetch.
Això és real, i és el motiu honest per triar Apollo. També és més limitat que la promesa. La consistència automàtica cobreix modificar una entitat que ja és al cache. No cobreix fer créixer una llista. En paraules d’Apollo, «a newly cached object isn’t automatically added to any list fields that should now include that object», així que una fila nova continua necessitant una funció d’actualització o un refetch.
La resta del cas d’Apollo s’aguanta per mèrits propis. La col·locació de fragments deixa que un component declari els camps que necessita i els compongui cap amunt per simple interpolació de template literals, sense pas de build; la generació de codi és opcional, i es guanya el lloc quan vols resultats tipats. Els cache redirects poden servir una vista de detall directament des de dades que una llista ja va demanar, però només quan cada camp que demana la query de detall ja és al cache. Un camp de més i la query sencera va a la xarxa. Les subscripcions i @defer tenen suport, i @defer necessita un handler de lliurament incremental més un polyfill de fetch en streaming a React Native, així que és «amb suport, amb configuració prèvia», no gratis.
I l’esquema importa més que tot això. La forma mateixa de PokéAPI, Pokémon que referencien tipus, habilitats, espècies i cadenes d’evolució, amb les mateixes entitats reutilitzades en moltes queries, és exactament la forma relacional on la normalització s’amortitza. Amb aquestes dades, el cache d’Apollo hi encaixa millor, i fingir el contrari seria l’home de palla que aquesta sèrie evita. (Relay és a la mateixa família. urql només hi entra quan hi afegeixes Graphcache: el seu cache de documents per defecte desa respostes senceres per query, més a prop del model d’RTK Query que del d’Apollo. Les contrapartides de Triar tracten de la família normalitzada, no d’una biblioteca concreta.)
El que la federació fa a la tria
Comença per la part que sorprèn. Apollo no té injectEndpoints, i no el necessita. Una operació és un document que s’executa contra un client, no un artefacte registrat en un store, així que qualsevol remote pot portar les seves pròpies queries contra un client compartit sense cap maquinària de registre. Un remote fins i tot pot ampliar el cache en muntar-se mitjançant cache.policies.addTypePolicies, que és API pública documentada. No hi ha guia oficial de micro-frontends (un fil sense resposta a la comunitat i un cas d’èxit són tot l’historial), però resulta que l’API del cache ho permet. A l’eix d’extensibilitat en runtime que importava al post 9, Apollo no va endarrerit.
Tampoc no comparteix el problema de context de TanStack. Apollo desa un únic context de React sobre la instància mateixa de React, sota un symbol conegut, precisament perquè dues còpies de la biblioteca no et puguin donar contextos divergents. L’error de «no client in context» només salta quan React mateix està duplicat. El cas singleton d’@apollo/client sota federació és una sola instància de cache i cap divergència de versions entre el client i els seus hooks, no la divisió del context.
La federació encara inclina la tria en dos llocs: el graf de tags i la transició. L’únic tag que torna a demanar dades entre remotes, i entre dos protocols, és coordinació que RTK Query té per construcció i que Apollo deixa a la convenció. I adoptar Apollo a mig camí de la transició vol dir aixecar un segon cache al costat del de RTK Query que ja executes, exactament la forma de dos caches del principi d’aquest post, durant tota la migració. Apollo Client 4 a més converteix rxjs en un peer obligatori i mou els seus exports de React, així que el bundle suma una dependència nova en lloc de canviar-ne una per una altra.
RTK Query
- Model de cache: per endpoint, refetch en invalidar
- Invalidació entre protocols: un graf de tags compartit, de sèrie
- Afegir queries des d'un remote:
injectEndpointsen runtime - Esquema relacional amb entitats reutilitzades: torna a demanar el que ja tenia
Apollo
- Model de cache: normalitzat per
__typename+ id, pedaç in situ - Invalidació entre protocols: per client; un segon cache per coordinar
- Afegir queries des d'un remote: documents contra el client; res a registrar
- Esquema relacional amb entitats reutilitzades: el cache s'amortitza
Triar
No hi ha guanyador absolut, així que baixa fins al cas que encaixi amb la teva app.
Transició, els dos backends vius: executa un sol client. Si l’app ja és a RTK Query, i aquesta sèrie ho és, això ho decideix. Un cache, un tag, sense dades obsoletes de dos caches per vigilar, i és el cas comú.
Destinació, GraphQL a tot arreu, amb una restricció de federació i estat compartit coordinat: RTK Query es queda. El preu honest és viure sense normalització: la invalidació per tags torna a demanar on Apollo aplicaria un pedaç in situ, i updateQueryData cobreix els pocs punts on un pedaç a mà val la pena. Canvies alguns viatges d’anada i tornada per un cache i un graf de tags entre remotes publicats de manera independent.
Destinació, GraphQL a tot arreu, un esquema relacional carregat d’entitats i cap restricció de federació: Apollo, i prou. El cache normalitzat és la raó de ser d’un client GraphQL, i sense una federació que estiri en contra, aquest és el motiu per adoptar-lo. Sense matisos.
Els senyals que cal vigilar són dos dies concrets. El dia que notis que la majoria de les teves invalidacions tornen a demanar dades que el cache ja tenia: la normalització t’hauria estalviat aquests viatges. I el dia que el segon backend entri en producció i dos caches es contradiguin a la pantalla sense cap error que ho expliqui. El primer és una empenta cap a Apollo. El segon és la raó per assegurar-te que només vas executar un client des del principi.
A continuació: el design system es converteix en un singleton federat, un sol paquet d’UI compartit en runtime, perquè cada remote renderitzi els mateixos components sense carregar amb la seva pròpia còpia.
Fonts
- RTK Query: personalitzar queries —
queryFncom a baseQuery inline, i l’exemple de baseQuery per a GraphQL - RTK Query: refetching automàtic — proveir i invalidar per tag
- Apollo: visió general del cache — normalització per
__typenamei id - Apollo: cache redirects — servir una query des del cache, i la regla de tots els camps presents
- Apollo:
@defer— lliurament incremental i la seva configuració - PokéAPI GraphQL — l’endpoint v1beta2 i el límit de 100 crides per hora
- graphql-request — el client basat en fetch que fa servir el queryFn
- react-native-module-federation — el repo d’acompanyament, la construcció al tag
post-10-two-backends